Собеседование техлида: система, код и команда
На собеседовании техлида оценивают не способность быстрее всех написать сложный фрагмент кода. Важнее, как кандидат видит систему целиком, делает риск обсуждаемым и помогает команде самостоятельно выпускать изменения. Сильный ответ строится вокруг конкретной развилки: какой контекст был известен, какие альтернативы рассматривались, что проверили до решения и по каким показателям поняли результат. Истории о личном героизме без изменения командной системы обычно работают против кандидата.
Границы домена и ответственность за модуль
Представьте доменный модуль расчёта скидок, который одновременно меняют команды каталога, заказов и программы лояльности. Формально у каждой команды своя часть кода, но общие модели, правила выпуска и таблицы заставляют изменения блокировать друг друга. В таком контексте вопрос не сводится к размеру файла. Техлид исследует связность бизнес-правил, направления зависимостей, владельцев данных и ответственность за контракт. Только после этого можно выбирать между новым сервисом, модульной границей внутри приложения или изменением ownership.
Начните с карты изменений за несколько месяцев. Какие задачи затрагивали модуль, кто ждал согласования, где возникали регрессии и какие данные менялись вместе? Если две команды постоянно правят одно правило, механическое разделение репозитория не уберёт совместную ответственность. Иногда полезнее назначить единого владельца контракта и дать остальным стабильный интерфейс. В другом случае правила действительно принадлежат разным bounded context, и их стоит развести вместе с моделями и жизненным циклом данных.
На интервью покажите, что архитектурная граница проверяется потоком работы. До изменения зафиксируйте lead time таких задач, число межкомандных блокировок и дефекты на стыке. После — оцените, стало ли решение выпускаться независимо. Фраза «выделили микросервис» не является результатом: новый сетевой вызов может добавить задержку и сложность, сохранив прежние согласования.
| Сигнал | Возможная причина | Что проверить перед решением |
|---|---|---|
| Три команды меняют один модуль | Смешаны доменные правила и ownership | Кто владеет инвариантами, данными и контрактом |
| Большие редкие релизы | Изменения долго ждут интеграции и проверки | Размер партии, cycle time и частоту отката |
| Review спорит о стиле | Стандарт и оценка риска не разделены | Что обязательно, а что является предложением |
| Один эксперт одобряет всё | Знание не передаётся в практику | Может ли другой инженер изменить и выпустить модуль |
Архитектурный выбор, spike и ADR
Когда инженеры защищают разные архитектуры, техлид не выбирает победителя по должности. Сначала команда согласует критерии: latency, стоимость владения, сложность миграции, обратимость, безопасность и влияние на разработку. Затем отделяет факты от предположений. Самую дорогую неопределённость проверяют коротким spike: например, измеряют пропускную способность очереди на данных, похожих на production, а не строят весь новый контур.
Результат spike должен менять решение. До начала запишите вопрос, ограничение времени и порог: «подходит, если p99 ниже 300 мс при десяти тысячах сообщений в минуту». Иначе эксперимент легко превратить в демонстрацию любимой технологии. Если обе альтернативы проходят порог, в выбор возвращаются стоимость, навыки команды и обратимость. Техническая проверка уменьшает неопределённость, но не принимает решение автоматически.
Долгоживущий выбор с существенными альтернативами фиксируют в ADR. В записи нужны контекст, решение, рассмотренные варианты, последствия и условие пересмотра. ADR не служит памятником правоте автора: он помогает новому инженеру понять, почему очевидная сегодня альтернатива была отклонена при других ограничениях. Мелкую локальную правку, которую легко изменить и которая не влияет на другие команды, документировать таким способом необязательно.
Хорошее архитектурное решение можно оспорить по критериям и новым данным. Если его защищает только авторитет техлида, команда получила зависимость от человека, а не механизм выбора.
Поток изменений и качество review
Редкие большие релизы увеличивают сразу несколько рисков: обратная связь приходит позже, причина отказа теряется среди десятков изменений, а rollback становится дороже. Техлид ищет способ уменьшить партию: feature flag, совместимые изменения контракта, независимый rollout и автоматическая проверка. Требование «делать PR меньше» без изменения декомпозиции и среды обычно приводит лишь к формальному дроблению одного неразделимого релиза.
Состояние потока нельзя описать одним количеством закрытых задач. Полезен набор показателей: lead time от начала работы до production, cycle time активной разработки, частота поставки, доля неуспешных изменений и время восстановления. Для качества добавляют escape rate — где обнаружены дефекты — и повторные открытия. Метрики читают вместе: ускорение поставки при росте отказов не является улучшением, а падение числа найденных багов может означать ухудшение тестирования.
Code review должно отделять обязательное от рекомендательного. Блокируют нарушение контракта, безопасности, корректности или принятого стандарта. Предложение переименовать переменную или выбрать другой паттерн помечают как необязательное, если оно не создаёт риск. Сложный спор выносят из десятков комментариев в короткое обсуждение с критериями, а итог возвращают в PR. Техлид следит не за количеством замечаний, а за тем, помогает ли review быстрее обнаружить существенную проблему и распространяет ли знание.
Качество review видно и по распределению участия. Если один эксперт неделями остаётся единственным одобряющим, система создаёт очередь и bus factor. Ротация ревьюеров, парное проектирование и понятные примеры стандартов расширяют круг решений, которые команда принимает без эскалации. При этом критические зоны можно защищать CODEOWNERS и дополнительной проверкой — передача знания не означает отмену контроля риска.
Надёжность, инциденты и технический долг
В инциденте техлид сначала ограничивает ущерб. Минимальное обратимое изменение, независимая проверка и ясный rollback безопаснее большой срочной переработки. Даже сильный разработчик не должен единолично отправлять непроверенный fix в production, если можно быстро организовать peer review. После стабилизации команда восстанавливает временную линию и режим отказа, связывая технические события с пользовательским сценарием.
Наличие логов ещё не даёт наблюдаемости. Если запрос проходит через несколько сервисов, нужны trace или request ID, структурированный контекст и метрики по операциям. Набор сигналов включает latency по перцентилям, error rate по причинам, saturation ограничивающего ресурса и пользовательский SLI. Общий uptime может оставаться зелёным, пока конкретная операция деградирует для важного сегмента.
Цель «100% uptime» не помогает выбирать между скоростью и надёжностью: она игнорирует стоимость и не оставляет error budget. Рабочая SLO задаёт событие, долю, порог и окно. При быстром расходовании бюджета команда ограничивает риск релизов; при устойчивом запасе может поставлять быстрее. Это не разрешение игнорировать отказ, а общий язык для приоритетов.
Технический долг отличается от старого кода измеримым последствием. Модуль может быть написан десять лет назад и стабильно выполнять задачу. Долг возникает, когда решение увеличивает lead time, частоту инцидентов, стоимость эксплуатации или блокирует нужное изменение. Размер предстоящего рефакторинга не доказывает величину долга: большая переделка может оказаться неоправданной. В roadmap помещают последствие, варианты снижения риска и способ проверить улучшение.
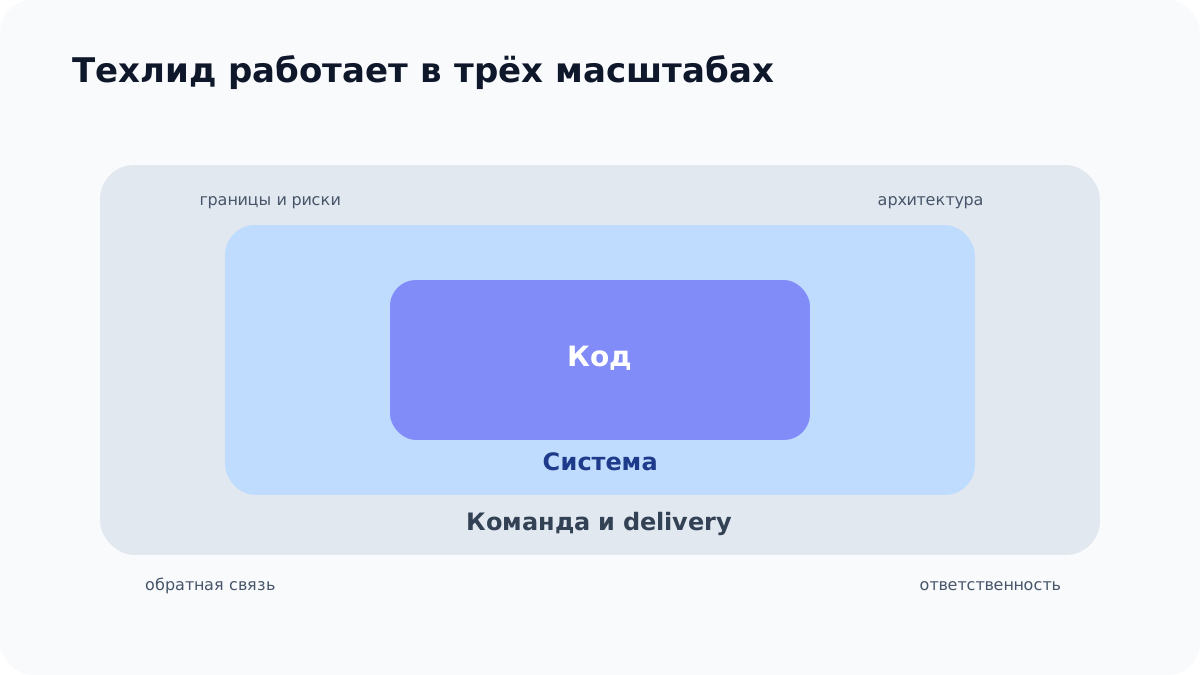
Схема связывает доменную границу, механизм решения, поток поставки и устойчивость команды без зависимости от hero mode.
Лидерство, которое переживает отсутствие техлида
Развитие инженера начинается с наблюдаемой компетенции, а не с передачи «более сложной задачи». Согласуйте, какое поведение должно измениться: самостоятельно собрать контекст ADR, провести rollout или организовать разбор инцидента. Затем дайте практику, своевременную обратную связь и возможность повторить действие. Контрольная точка проверяет направление, но не диктует каждый шаг.
Особенно опасен модуль, который понимает один человек. Документация полезна, но сама по себе не доказывает передачу знания. Сначала другой инженер работает в паре, затем самостоятельно готовит изменение, проходит review, выпускает его и наблюдает результат. Только успешный полный цикл показывает, что знания стали рабочими. Если эксперт молча исправил критическую часть перед релизом, риск сохранился, даже если задача закрыта.
Техлид не обязан принимать каждое решение. Его ответственность — создать контекст, критерии и путь эскалации для решений разного риска. Локальные обратимые выборы команда делает самостоятельно; системные и необратимые обсуждает шире. Так скорость не зависит от календаря одного человека, а техлид сохраняет внимание для границ системы и рисков, которые нельзя увидеть из одного PR.
На собеседовании подготовьте три истории: спорный архитектурный выбор, улучшение потока поставки и передача критического знания. Сравните требования в вакансиях техлидов и зарплатные ориентиры специализации. В материалах блога HireSeeker можно найти смежные кейсы разработки и управления. Для каждой истории назовите исходные показатели, альтернативу, личное действие и результат команды без вашего постоянного участия. Такой финал показывает лидерство точнее, чем перечень технологий.