Системный архитектор: как проходить архитектурный разбор
Архитектурный разбор проверяет не память на шаблоны, а качество решений под неполными требованиями. Кандидат, который сразу рисует Kafka, Kubernetes и десяток сервисов, пропускает самую важную часть: что именно система должна гарантировать, где допустим риск и как она будет меняться из текущего состояния. Сильный системный архитектор ведёт разговор через вопросы, фиксирует assumptions и делает trade-offs проверяемыми.
Сначала ограничьте задачу и критерий успеха
Переформулируйте запрос как пользовательский и бизнес-поток. Кто вызывает систему, какое действие завершается, что считается успехом и какое последствие у отказа. Затем выясните объём: users, requests, размер события, read/write ratio, география, пики, retention. Не угадывайте точное число; предложите диапазон и покажите, какое решение меняется на его границе.
Отделите hard constraints от preferences. Регуляторное хранение в стране и подтверждённый RPO могут быть жёсткими. Желание «использовать микросервисы» — скорее preference, пока не названа организационная или техническая причина. Assumption log держите на доске: значение, источник, риск ошибки и действие для проверки.
Сделайте один расчёт порядка величины. Суточный объём, peak RPS, storage growth или outbound bandwidth помогают поймать невозможную схему. Расчёт не должен занимать интервью; его задача — выбрать класс решения и запас. Всегда проговаривайте единицы и headroom.
Хороший вопрос меняет архитектурную развилку. Остальные вопросы можно отложить и обозначить assumption.
На вакансиях системных архитекторов особенно ценится способность управлять неопределённостью. Reviewer должен видеть не только диаграмму, но и список решений, которые вы сознательно пока не приняли.
Сделайте NFR измеримыми
«Быстро, надёжно и масштабируемо» ничего не специфицирует. Для latency задайте percentile, операцию и точку измерения. Availability свяжите с user journey и окном. Consistency опишите по инварианту. RPO и RTO разделите: сколько данных допустимо потерять и сколько времени восстанавливать сервис.
| NFR | Проверяемая формулировка | Архитектурное влияние | Evidence |
|---|---|---|---|
| Latency | p99 checkout API менее заданного порога | sync path, cache, geography | load test и tracing |
| Availability | monthly SLO для оформления заказа | redundancy, degradation | error budget и game day |
| Consistency | заказ не списывает оплату дважды | idempotency, ledger, transaction boundary | invariant tests |
| Recovery | RPO/RTO по данным заказа | replication, backup, runbook | restore drill |
Обсудите конфликт NFR. Сильная consistency между регионами увеличивает latency и снижает availability при partition. Полная история аудита повышает storage и усложняет deletion. Скажите, какой user outcome защищаете, и предложите degradation: читать stale каталог можно, подтверждать оплату без ledger нельзя.
Security и operability входят в базовый дизайн. Определите trust boundaries, identity, secrets, audit и sensitive data. Для operations добавьте deploy, observability, capacity, incident ownership и cost attribution. Компонент, который никто не умеет диагностировать, не готов к production.
Покажите trade-offs на альтернативных схемах
Сначала нарисуйте минимальную жизнеспособную архитектуру. Затем найдите её предел и введите следующий механизм. Один service и relational database часто достаточны для начала разговора; очередь появляется из-за необходимости сгладить пик или развязать отказ, а не потому что «так принято».
Для ключевых развилок используйте decision table: варианты, критерии, выбранное решение, принятый риск и trigger пересмотра. Например, synchronous call проще и даёт немедленный ответ, event flow изолирует consumers, но добавляет eventual consistency, duplicates и observability. Выбор зависит от user contract.
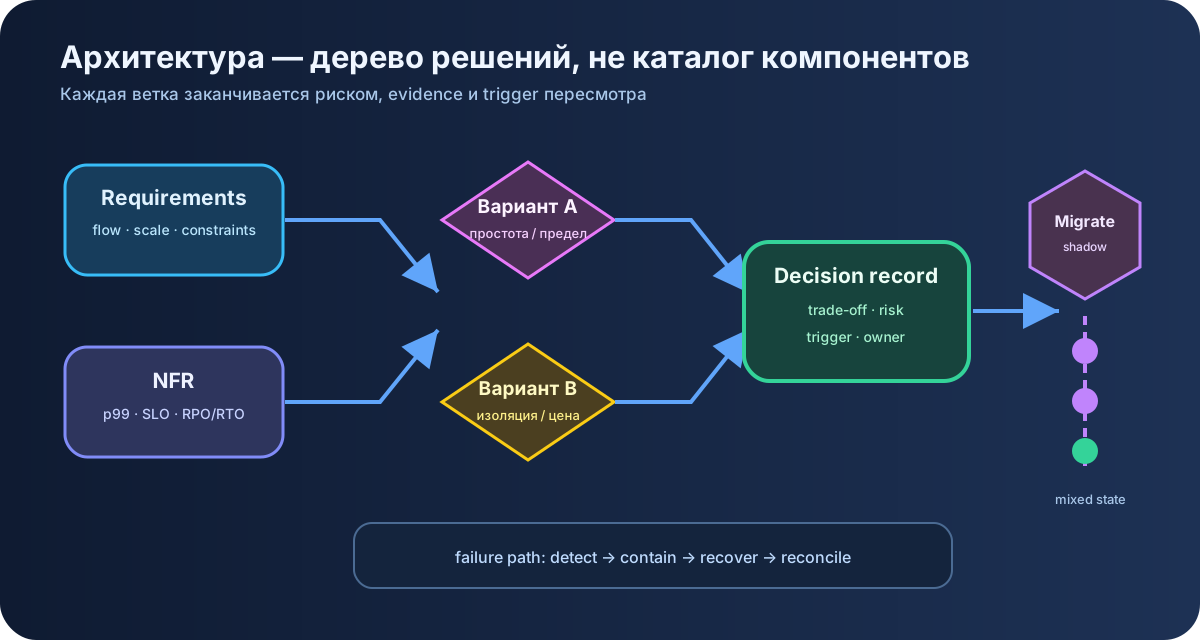 Дерево решений начинается с NFR и заканчивается не компонентами, а планом эволюции.
Failure path проговаривайте для каждой границы: timeout, partial commit, duplicate message, dependency outage, hot partition, poison event. Не перечисляйте бесконечно; выберите самый дорогой класс и доведите до detection, containment, recovery и reconciliation.
Объясните данные. Назовите system of record, ownership, keys, transaction boundary, lifecycle и read models. Если сервисы разделяют одну таблицу, независимость ограничена. Если каждое поле размножено событиями, нужна стратегия schema evolution и replay.
Проведите миграцию без магического переключателя
Интервью часто начинается с greenfield, хотя реальная работа почти всегда brownfield. Спросите, что существует, какие consumers нельзя остановить и как измеряется parity. Предложите этапы: instrumentation, façade или capture, shadow traffic, двойное чтение либо запись при понятной consistency, backfill, постепенное переключение и удаление старого пути.
Dual write опасен без общей транзакции. Обсудите outbox, idempotency, reconciliation и источник истины. Shadow сравнение должно иметь правила эквивалентности и бюджет расхождений. Если новая система меняет semantics, byte-to-byte parity бессмысленна; сравнивают пользовательский инвариант.
Rollback — не просто вернуть deployment. После миграции данных старая версия может не понимать новую форму. Нужны backward-compatible schema, feature flags, reversible traffic и plan forward-fix. Назовите точку, после которой обратный ход становится дороже завершения миграции.
Архитектура миграции обязана описывать смешанное состояние, потому что именно в нём система живёт дольше всего.
Уровень и зарплаты системных архитекторов зависят от масштаба решений, числа команд и цены ошибки. В кейсе уточняйте не только RPS, но и организационный контур: кто владеет API, on-call и migration rollout.
Ведите интервью как совместный design review
Периодически суммируйте: «мы защищаем X, допускаем Y, главный риск Z». Это даёт интервьюеру возможность исправить assumption и показывает управление разговором. Оставляйте пространство на доске для requirements, data, components, failure paths и decisions; связанная схема читается лучше облака стрелок.
Если интервьюер меняет условие, не защищайте старый рисунок. Покажите impact: новый multi-region requirement меняет consistency, routing, data residency и operations. Сначала обновите NFR, затем затронутые решения. Умение спокойно перестроить схему важнее угадывания скрытого ответа.
Следите за глубиной. Лучше разобрать один critical path и один background flow, чем назвать двадцать сервисов. На каждом переходе спрашивайте: что передаётся, кто владелец, что при повторе, какой timeout, что наблюдаем. Так диаграмма превращается в исполнимый контракт.
Завершите рисками и следующими проверками: load test горячего ключа, restore drill, spike schema evolution, security review trust boundary, cost model трафика. Расставьте приоритет по цене ошибки и необратимости. Финальная фраза должна быть решением на текущем evidence, а не обещанием идеальной системы.
После интервью пересмотрите разбор: где assumption появился молча, какой NFR остался словом, где компонент не имел failure path. Один и тот же prompt можно повторить с другим ограничением — например, data residency или десятикратным пиком. Это тренирует архитектурное мышление лучше заучивания очередной эталонной картинки.
Добавьте reconciliation-сценарий миграции. Новый consumer обработал событие, старый store записал результат, а projection упала после timeout. Повтор сообщения безопасен только при idempotency key; отдельный сверяющий job сравнивает business invariant, а не timestamps двух баз. В разборе нужно назвать источник истины, окно допустимого расхождения и владельца manual repair. Такой эпизод быстро выявляет, умеет ли кандидат проектировать промежуточное состояние.
Cost trade-off тоже достоин доски. Multi-region active-active сокращает latency части пользователей, но добавляет межрегиональный трафик, сложный failover и дорогую consistency. Предложите сначала измерить долю удалённых запросов и бизнес-цену задержки. Возможно, read replica и региональный cache решат каталог, а денежный ledger останется в одном write region. Компоненты разделяются по инварианту, а не по модному требованию «глобальности».
Для hot partition назовите detection и эволюцию ключа. Один крупный tenant может перегрузить shard, хотя средний RPS выглядит безопасно. Метрики по key distribution, лимит per tenant и migration отдельного диапазона дают управляемый путь. Простое увеличение числа partitions не перераспределит уже горячий ключ автоматически.
В финальном risk register оставьте владельца и дату. Load test принадлежит performance owner, restore drill — storage-команде, проверка trust boundary — security. Архитектор не обязан выполнять каждую проверку сам, но отвечает, чтобы неизвестность стала назначенной работой с критерием выхода.
Для API evolution назовите consumer contract. Новое поле сначала optional для чтения, producers заполняют его с метрикой coverage, затем consumers переходят на новую semantics. Старое поле удаляют только после реестра потребителей и наблюдаемого нулевого трафика. Это архитектура изменения, а не одна конечная схема.
В decision record укажите точку необратимости: после удаления legacy writer возврат потребует backfill, поэтому перед ней проводят restore rehearsal и подписывают owners всех remaining consumers.