профилирование запросов в postgresql с помощью команды Explain
Обновлено
Когда запрос тормозит, сначала нужно понять, где проходит время: в ожидании соединения, блокировке, чтении данных, соединении таблиц или обработке результата. EXPLAIN помогает исследовать работу PostgreSQL внутри отдельного SQL-запроса. Вместе со статистикой сервера он превращает предположение «нужен индекс» в проверяемую гипотезу.
Руководство рассчитано на PostgreSQL 18. Базовые примеры подходят и для более ранних поддерживаемых версий; новые параметры отмечены отдельно. Здесь разобраны все параметры EXPLAIN этой версии, основные узлы плана и порядок измерений. Названия узлов у расширений и внешних источников могут отличаться.
1. Что именно измеряет EXPLAIN
План и фактическое выполнение
Обычный EXPLAIN показывает выбранный план без выполнения исследуемого запроса. EXPLAIN ANALYZE запускает его и добавляет измерения. Это два разных режима: оценка планировщика может расходиться с тем, что происходит на реальных данных.
-- Только выбранный план.
EXPLAIN
SELECT id, total FROM orders WHERE customer_id = 42;

-- Запрос действительно выполняется.
EXPLAIN (ANALYZE, BUFFERS, SETTINGS)
SELECT id, total FROM orders WHERE customer_id = 42;
Планировщик использует статистику распределения значений, доступные индексы и настройки стоимости операций. Исполнитель следует выбранному дереву: сканирует, фильтрует, соединяет и агрегирует строки. Инструментирование добавляет счётчики строк, повторов, обращений к буферам и, если включён TIMING, времени узлов. Это создаёт дополнительную нагрузку: измерение само немного меняет измеряемый процесс.
Слово ANALYZE встречается и в отдельной команде ANALYZE orders. Она обновляет статистику таблицы для планировщика. EXPLAIN ANALYZE SELECT ... измеряет выполнение SELECT и эту статистику не обновляет.
Безопасный первый замер
Для чтения начните с короткой транзакции, ограничений времени и режима READ ONLY:
BEGIN READ ONLY;
SET LOCAL statement_timeout = '10s';
SET LOCAL lock_timeout = '1s';

EXPLAIN (ANALYZE, BUFFERS, SETTINGS, TIMING OFF)
SELECT id, total FROM orders WHERE customer_id = 42;

ROLLBACK;
TIMING OFF сохраняет фактические строки и общее время, но убирает частые замеры часов внутри узлов. Когда станет понятно, какую часть плана исследовать, повторите с TIMING ON. Таймаут не даёт частичного завершённого плана: при отмене понадобится иной способ наблюдения.
Для UPDATE или DELETE используется обычная транзакция с ROLLBACK:
BEGIN;
SET LOCAL statement_timeout = '5s';
SET LOCAL lock_timeout = '1s';
EXPLAIN (ANALYZE, BUFFERS, WAL)
UPDATE orders SET total = total + 1 WHERE id = 100;
ROLLBACK;
EXPLAIN ANALYZE выполняет изменения и триггеры. ROLLBACK отменит транзакционные изменения данных, но запрос всё равно создаст нагрузку, возьмёт блокировки и может записать WAL. Значения sequence и внешние эффекты функций откат не возвращает. Запросы с такими эффектами исследуйте на подготовленном стенде.
Учебный набор данных
Чтобы пройти примеры самостоятельно, создайте таблицу в отдельной учебной базе. Скрипт ниже не предназначен для production. Имена таблиц в последующих примерах относятся к этой базе.
CREATE TABLE orders (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id integer NOT NULL,
    status text NOT NULL,
    created_at timestamptz NOT NULL,
    total numeric(12,2) NOT NULL
);

INSERT INTO orders (customer_id, status, created_at, total)
SELECT
    (g % 10000)::integer,
    CASE WHEN g % 10 = 0 THEN 'new' ELSE 'paid' END,
    TIMESTAMPTZ '2026-01-01 00:00:00+00' + g * INTERVAL '1 minute',
    (g % 20000)::numeric / 100
FROM generate_series(1, 200000) AS g;

ANALYZE orders;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, created_at, total
FROM orders
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 20;

CREATE INDEX orders_customer_created_idx
    ON orders (customer_id, created_at DESC)
    INCLUDE (id, total);

-- Повторите тот же EXPLAIN и сохраните оба результата.
У индекса есть конкретная задача: найти заказы клиента в нужном порядке и предоставить выбранные столбцы. Сравнивайте фактическую работу до и после, а не само появление слова Index. Время на вашей машине будет зависеть от версии, настроек и состояния кеша; обещанного ускорения в фиксированное число раз здесь нет.
2. Как читать дерево плана
Результат движется от дочерних узлов к родительским, хотя исполнитель обычно запрашивает очередные строки сверху вниз. Узел Sort может сначала потребовать весь вход, а Limit — остановить чтение, когда строк уже достаточно.
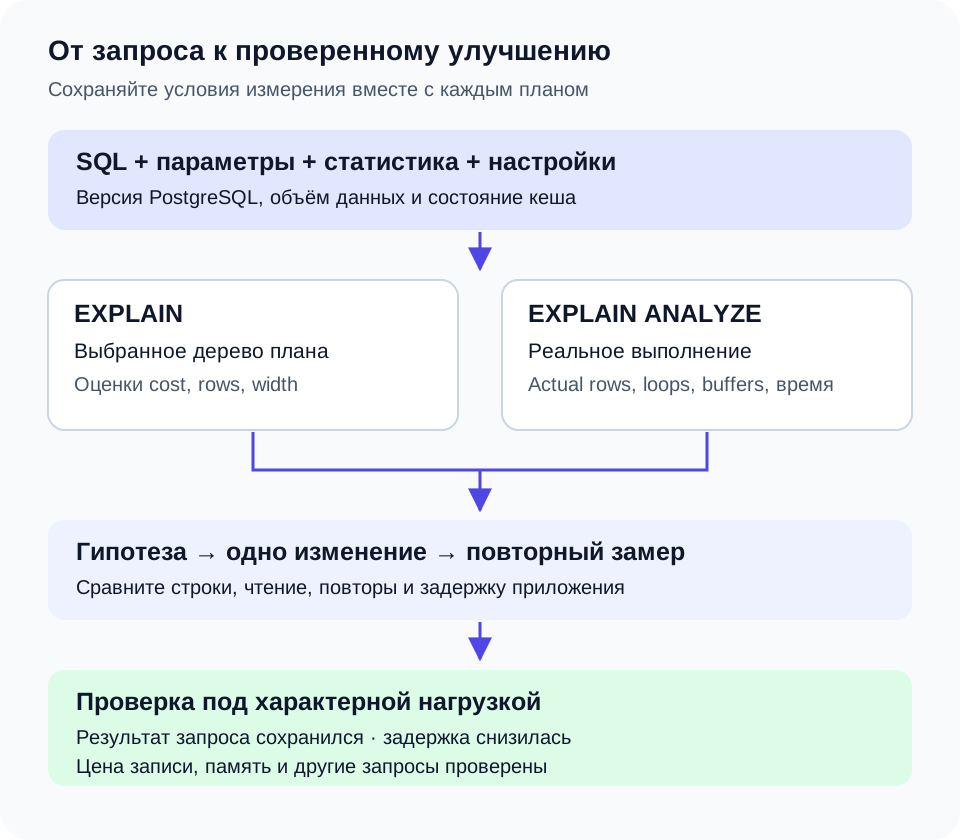 Одна итерация профилирования: сохранить исходный план, проверить гипотезу и повторить измерение в сопоставимых условиях.
Cost, rows, width и actual
Ниже учебная строка плана с условными числами, а не результат запуска на сервере:
Index Scan using orders_customer_created_idx on orders
  (cost=0.42..86.00 rows=20 width=24)
  (actual time=0.030..0.140 rows=20 loops=1)
  Index Cond: (customer_id = 42)
cost=0.42..86.00 — оценки затрат до первой строки и до завершения узла. Это условные единицы, не миллисекунды. rows=20 — оценка числа выходных строк; width=24 — их средней ширины в байтах. Actual time показывает миллисекунды до первой строки и завершения одного выполнения. Разницу между оценкой и фактом сопоставляют по rows, а не делением cost на миллисекунды. Формат и интерпретация плана.
У повторяющегося узла фактические строки и времена усредняются по loops. Например:
actual time=0.010..0.200 rows=3 loops=5000
Это примерно 15 000 выданных строк и 1000 мс накопленного времени узла. Операция на 0,2 мс перестаёт быть дешёвой после пяти тысяч повторов. Времена родителей включают работу потомков, поэтому складывать весь столбец нельзя. При параллельном выполнении накопленная работа процессов тем более не равна времени ожидания клиента.
Основные способы доступа и соединения
| Узел | Что происходит | Что исследовать |
|---|---|---|
| Seq Scan | Читается таблица с проверкой условия | Долю нужных строк и объём чтения |
| Index Scan | Индекс находит строки, таблица предоставляет данные | Повторы и обращения к heap |
| Index Only Scan | Данные доступны из индекса | Heap Fetches и visibility map |
| Bitmap Index / Heap Scan | Сначала собираются адреса, затем читаются страницы | Lossy blocks и перепроверки |
| Nested Loop | Для строк внешнего входа выполняется внутренний | Размер внешнего входа и loops |
| Hash Join | Строится хеш-таблица одного входа | Размер build-стороны и batches |
| Merge Join | Сопоставляются упорядоченные входы | Стоимость получения порядка |
Seq Scan может быть хорошим выбором: когда нужна большая часть таблицы, обход индекса с последующими обращениями к строкам добавляет работу. Nested Loop тоже нормален для небольшого внешнего набора и быстрых точечных поисков. Проблема появляется, когда ожидаемые десятки строк превращаются в сотни тысяч.
У Index Only Scan название не гарантирует отсутствия обращений к таблице. Если visibility map не подтверждает видимость страницы, PostgreSQL проверяет heap; это отражается в Heap Fetches. INCLUDE делает данные доступными в индексе, но увеличивает его размер и стоимость обслуживания. Покрывающие индексы и видимость.
Фильтры и вспомогательные узлы
Index Cond ограничивает поиск по индексу, Filter отбрасывает уже полученные кандидаты. Большое Rows Removed by Filter подсказывает, сколько лишней работы выполняется; при loops это округлённое среднее. Recheck Cond и Rows Removed by Index Recheck относятся к перепроверке кандидатов, в частности при неточных bitmap-страницах. Join Filter применяется при соединении и требует отдельного внимания к объёму пар.
В более сложных деревьях встречаются и другие операции:
Aggregate,GroupAggregate,HashAggregateвычисляют агрегаты разными способами; смотрите число групп и расход памяти.WindowAggвыполняет оконные функции; проверьте необходимые сортировки и размер разделов.Append,Merge Appendобъединяют входы, например секции таблицы; второй сохраняет порядок.Materializeсохраняет промежуточный результат для повторного чтения;Memoizeкеширует результаты параметризованного внутреннего входа.Unique,SetOpреализуют удаление дублей и операции над множествами.CTE Scan,Subquery Scan,Function Scan,Values Scan,Foreign Scanуказывают источник строк;Custom Scanможет принадлежать расширению.
SubPlan под повторяющимся узлом способен означать тысячи запусков коррелированного подзапроса. InitPlan обычно вычисляет значение один раз за выполнение соответствующего плана. У never executed исследуйте причину: ветка могла не понадобиться из-за LIMIT, условий или отсечения секций. Само отсутствие выполнения ошибкой не считается.
3. Все параметры EXPLAIN PostgreSQL 18
Современная форма принимает параметры в скобках. Для булевых опций допустимы ON/OFF, TRUE/FALSE, 1/0; пропущенное значение означает TRUE. Команда применима к SELECT, INSERT, UPDATE, DELETE, MERGE, VALUES, EXECUTE, DECLARE, CREATE TABLE AS и CREATE MATERIALIZED VIEW AS. Если SERIALIZE указан без значения, выбирается TEXT.
| Параметр | Что добавляет или меняет | Ограничение / значение по умолчанию |
|---|---|---|
| ANALYZE | Фактическое выполнение | OFF |
| VERBOSE | Столбцы, схемы, дополнительные детали | OFF |
| COSTS | Оценки стоимости, строк, ширины | ON |
| SETTINGS | Отличающиеся от заводских настройки планирования | OFF |
| GENERIC_PLAN | План без конкретных значений параметров | OFF; несовместим с ANALYZE |
| BUFFERS | Счётчики буферов | В 18 включён при ANALYZE |
| SERIALIZE | Преобразование результата: TEXT/BINARY | NONE; требует ANALYZE |
| WAL | WAL records, fpi, bytes, переполнения буферов | OFF; требует ANALYZE |
| TIMING | Время отдельных узлов | ON при ANALYZE |
| SUMMARY | Итоговая сводка | Включена при ANALYZE |
| MEMORY | Память планирования | OFF |
| FORMAT | TEXT, JSON, YAML или XML | TEXT |
Это полный набор опций команды для выбранной версии. Справочник EXPLAIN.
GENERIC_PLAN появился в PostgreSQL 16, MEMORY и SERIALIZE — в 17. MEMORY не показывает общую пиковую память запроса: для сортировок и хеширования изучают показатели соответствующих узлов. SERIALIZE учитывает преобразование данных и связанные обращения, например к TOAST, но не отправляет строки клиенту. Передачу по сети и клиентскую обработку нужно измерять отдельно. Изменения PostgreSQL 17, GENERIC_PLAN в PostgreSQL 16.
Три полезных набора параметров
-- Первый замер с меньшими затратами на часы.
EXPLAIN (ANALYZE, BUFFERS, SETTINGS, TIMING OFF)
SELECT id, total FROM orders WHERE customer_id = 42;

-- Подробный профиль: PostgreSQL 17+.
EXPLAIN (
    ANALYZE, BUFFERS, VERBOSE, SETTINGS,
    MEMORY, SERIALIZE TEXT, SUMMARY
)
SELECT id, total FROM orders WHERE customer_id = 42;

-- Машиночитаемый артефакт для сравнения и визуализации.
EXPLAIN (ANALYZE, BUFFERS, SETTINGS, FORMAT JSON)
SELECT id, total FROM orders WHERE customer_id = 42;
В psql JSON удобно сохранить без табличного оформления:
\pset format unaligned
\pset tuples_only on
\o orders-plan.json
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT id, total FROM orders WHERE customer_id = 42;
\o
\pset tuples_only off
\pset format aligned
Сохраняйте вместе с планом SQL, параметры и контекст запуска. Перед передачей плана третьим лицам проверьте литералы, имена объектов и сведения о данных. Визуализация помогает ориентироваться в большом дереве, но не исправляет ошибочную трактовку loops и включённого времени.
4. Как найти причину медленного выполнения
Ошибки оценки количества строк
Ищите первый узел, где оценка существенно расходится с фактом. Если сканирование ожидало 50 строк, а вернуло 80 000, последующий неудачный Nested Loop может быть следствием этой ошибки. Замена JOIN без разбора исходной оценки лечит результат, а не причину.
Начните со статистики таблицы и распределения значений:
SELECT attname, n_distinct, null_frac,
       most_common_vals, most_common_freqs
FROM pg_stats
WHERE schemaname = 'public' AND tablename = 'orders';

ANALYZE orders;

-- Для столбца со сложным распределением, если обычной статистики мало.
ALTER TABLE orders ALTER COLUMN customer_id SET STATISTICS 500;
ANALYZE orders;

-- Если фильтры используют связанные столбцы одной таблицы.
CREATE STATISTICS orders_customer_status_stats (mcv, dependencies)
ON customer_id, status FROM orders;
ANALYZE orders;
В учебных данных customer_id и status связаны правилом генерации. Предположение о независимости условий здесь может дать плохую оценку. Extended statistics помогают описать такие связи, но не устраняют любые ошибки селективности и не служат универсальным решением оценок JOIN. Повышение statistics target увеличивает затраты на сбор и хранение статистики. Статистика планировщика.
Сравнивайте узлы, которые действительно выработали вход. Если Limit остановил сканирование после двадцати строк, нельзя объявлять ошибкой оценку полного набора в несколько тысяч строк.
Что означают BUFFERS и I/O
Условный фрагмент:
Buffers: shared hit=420 read=80 dirtied=3 written=2
         temp read=120 written=125
I/O Timings: shared read=8.100
Hit — обращение к странице, уже находившейся в shared buffers. Read — загрузка в буфер PostgreSQL; данные могли прийти из кеша ОС, поэтому число read не доказывает физическое чтение накопителя. Dirtied считает страницы, которые запрос сделал грязными; written — страницы, записанные этим backend при вытеснении. Эти значения не равны числу изменённых строк.
Shared относится к обычным таблицам и индексам; local — к временным таблицам; temp — к временным рабочим файлам операций. Числа отражают обращения, включая повторные, а не количество уникальных страниц. Буферы родительского узла включают дочерние; складывать дерево целиком нельзя. В отличие от actual rows, буферные счётчики не нужно повторно умножать на loops.
Размер блока проверяется через SHOW block_size, часто это 8192 байта. Умножение read на размер блока даст объём загрузок в буферы, но не уникальный рабочий набор и не точный физический I/O устройства.
При включённом track_io_timing появляются времена операций ввода-вывода. Включение требует соответствующих прав и имеет собственную измерительную стоимость. Системные I/O-метрики и pg_stat_io помогают дополнить картину, но не являются детализацией одного выбранного запроса. Мониторинг PostgreSQL.
Не вычисляйте CPU-время вычитанием I/O Timings из Execution Time: остаются блокировки, инструментирование и другие расходы, а параллельные и асинхронные операции могут перекрываться.
Сортировки, хеширование и память
Sort Method: quicksort показывает сортировку в памяти. top-N heapsort часто встречается при ORDER BY с LIMIT. external merge вместе с Disk указывает на использование диска. Incremental Sort использует уже имеющийся порядок по префиксу ключей.
У Hash и HashAggregate изучайте Memory Usage, Batches, Disk Usage и временные блоки. Несколько batches — повод проверить разбиение работы и сброс на диск. Для эксперимента измените память только внутри своей транзакции:
BEGIN;
SET LOCAL work_mem = '32MB';
EXPLAIN (ANALYZE, BUFFERS)
SELECT customer_id, sum(total)
FROM orders
GROUP BY customer_id
ORDER BY sum(total) DESC;
ROLLBACK;
work_mem — бюджет отдельной операции, не всей сессии. Несколько узлов, параллельные процессы и одновременные запросы расходуют память совместно; хеш-операции дополнительно учитывают hash_mem_multiplier. Повышать work_mem глобально по одному успешному замеру опасно для общей ёмкости сервера. Настройки памяти.
Перед увеличением бюджета проверьте, можно ли сократить вход: раньше применить фильтр, убрать ненужные широкие столбцы или получить требуемый порядок из подходящего индекса. Сортировка десяти миллионов строк и сортировка десяти тысяч требуют разных решений.
Параллелизм, JIT и скрытые расходы
В параллельном плане сравните Workers Planned и Workers Launched. Недостающий worker меняет реальные условия выполнения. Gather собирает потоки без сохранения общего порядка; Gather Merge объединяет упорядоченные потоки. VERBOSE помогает увидеть распределение работы по процессам. Сильный перекос между workers может объяснить, почему дополнительные процессы мало помогли. Параллельные планы.
У короткого запроса заметное время JIT-компиляции может превышать выигрыш на обработке строк. Проверьте гипотезу через SET LOCAL jit = off и повторите тот же запрос; для длинной аналитики результат может быть обратным. Решение о JIT связано с оценочной стоимостью плана. Когда применяется JIT.
Planning Time относится к планированию; Execution Time — к выполнению с инструментированием. Чтение SQL, ожидание соединения из пула, доставка всех строк клиенту и их обработка приложением требуют отдельных измерений. Поэтому «в EXPLAIN 30 мс, в API 900 мс» — повод разложить запрос приложения на этапы, а не спорить с планом.
Время триггеров при изменениях выводится отдельно. Отложенные constraint triggers могут сработать лишь при завершении транзакции и не попасть в Execution Time команды. WAL bytes полезны для оценки нагрузки записи, но сами по себе не показывают задержку COMMIT, fsync или ожидание синхронной реплики.
5. Как профилировать реальные запросы приложения
Сначала выбрать запрос: pg_stat_statements
EXPLAIN исследует один запуск. Для поиска систематической нагрузки используйте pg_stat_statements: расширение накапливает статистику по нормализованным запросам. Для подключения администратор добавляет модуль в shared_preload_libraries, сохраняя уже настроенные библиотеки, перезапускает сервер и выполняет CREATE EXTENSION в нужной базе. Для вычисления query ID нужен compute_query_id в режиме auto/on либо совместимый внешний механизм.
CREATE EXTENSION IF NOT EXISTS pg_stat_statements;

SELECT queryid, calls,
       round(total_exec_time::numeric, 1) AS total_ms,
       round(mean_exec_time::numeric, 2) AS mean_ms,
       round(max_exec_time::numeric, 2) AS max_ms,
       rows, shared_blks_read, temp_blks_written,
       query
FROM pg_stat_statements
WHERE dbid = (SELECT oid FROM pg_database
              WHERE datname = current_database())
ORDER BY total_exec_time DESC
LIMIT 20;
Сортировка по total_exec_time показывает запросы с большим суммарным вкладом. По mean_exec_time — дорогие отдельные вызовы. Оценивайте обе стороны: запрос на 3 мс при сотнях тысяч вызовов может стоить дороже редкого запроса на секунду.
Это агрегаты с момента сброса или начала накопления, а не готовый профиль последней минуты. Сравнивайте разности снимков за выбранный интервал; не сбрасывайте общую статистику ради своего эксперимента. Mean и max не заменяют p95/p99, а нормализованный текст не восстанавливает параметры проблемного вызова. Статистика планирования появляется при отдельном включении track_planning. pg_stat_statements.
Затем сохранить медленный план: auto_explain
Редкий медленный вызов трудно повторить вручную. auto_explain записывает планы выполненных запросов в журнал. Следующий пример относится к отдельной диагностической сессии с необходимыми административными правами:
LOAD 'auto_explain';
SET auto_explain.log_min_duration = '500ms';
SET auto_explain.log_analyze = on;
SET auto_explain.log_buffers = on;
SET auto_explain.log_timing = off;
SET auto_explain.log_format = 'json';
SET auto_explain.sample_rate = 0.1;
SET auto_explain.log_nested_statements = on;
SET auto_explain.log_parameter_max_length = 0;

-- Далее выполняются исследуемые запросы этой сессии.
LOAD действует на текущий backend. Чтобы охватить соединения приложения, администратор настраивает загрузку модуля и параметры для соответствующих сессий. log_nested_statements помогает увидеть SQL внутри функций. Sample rate ограничивает долю наблюдаемых вызовов; короткий пробный запуск может не дать ни одного плана.
Порог 500 мс ограничивает запись в журнал, но не делает инструментирование бесплатным: при log_analyze счётчики нужны ещё до того, как станет известна длительность. TIMING OFF уменьшает накладные расходы. Отключение вывода параметров не обезличивает литералы в самом SQL; доступ к журналам и срок хранения нужно настроить осознанно. auto_explain.
Generic plan и custom plan
Запрос из ORM может использовать подготовленное выражение. Custom plan учитывает конкретные значения параметров; generic plan предназначен для повторного использования. Если одному клиенту принадлежит половина таблицы, а другому двадцать строк, один план может обслуживать их с разной эффективностью.
PREPARE orders_by_customer(integer) AS
SELECT id, total FROM orders WHERE customer_id = $1;

BEGIN;
SET LOCAL plan_cache_mode = force_custom_plan;
EXPLAIN (ANALYZE, BUFFERS) EXECUTE orders_by_customer(42);

SET LOCAL plan_cache_mode = force_generic_plan;
EXPLAIN (ANALYZE, BUFFERS) EXECUTE orders_by_customer(42);
ROLLBACK;

DEALLOCATE orders_by_customer;

-- PostgreSQL 16+: generic-план без исполнения и без PREPARE.
EXPLAIN (GENERIC_PLAN)
SELECT id, total FROM orders WHERE customer_id = $1::integer;
Этот эксперимент сравнивает планы, но его порядок прогревает кеш. Повторите измерения с перестановкой вариантов. Принудительные режимы полезны для диагностики; переносить их в постоянные настройки следует только после проверки характерных параметров нагрузки. Поведение prepare в драйвере и пулере тоже входит в условия воспроизведения. Подготовленные запросы.
Если запрос ждёт блокировку
План не объяснит сам по себе, кто удерживает блокировку. Пока проблемный запрос выполняется, из другой сессии посмотрите активность:
SELECT pid, state, wait_event_type, wait_event,
       now() - query_start AS elapsed,
       pg_blocking_pids(pid) AS blocking_pids
FROM pg_stat_activity
WHERE datname = current_database()
  AND state = 'active'
  AND pid != pg_backend_pid();
Wait event — снимок текущего состояния, не история всего запроса. Отсутствие ожидания в одном снимке не доказывает, что запрос всё время расходовал CPU. Для просмотра чужих сессий могут понадобиться дополнительные права. Блокировки и порядок действий при инциденте разобраны в статье о диагностике медленного PostgreSQL.
6. Как доказать, что изменение помогло
Профилирование должно завершаться проверкой гипотезы. «План стал красивее» или «появился индекс» не описывает результат для пользователя приложения.
- Сохраните исходный SQL с типами параметров, версию PostgreSQL, план и параметры сессии. Зафиксируйте, откуда взята длительность: приложение, pg_stat_statements или EXPLAIN.
- Выберите несколько характерных наборов параметров: частое значение, редкое, большой диапазон, пустой результат. Проверьте, совпадают ли данные и права с окружением приложения.
- Получите базовый профиль. Не смешивайте первый запуск после простоя с повторным чтением из кеша. Сохраняйте несколько повторов, а не один самый быстрый результат.
- Сформулируйте одно объяснение: неверная оценка строк, лишнее чтение, большое число loops, сброс сортировки на диск, generic plan или ожидание блокировки.
- Измените один фактор. Повторите измерения при сопоставимой нагрузке и убедитесь, что запрос возвращает прежний результат.
- Проверьте побочную стоимость: размер индекса, замедление INSERT/UPDATE, расход памяти при конкуренции, WAL и задержки других запросов.
Не очищайте системные кеши production ради «чистого» замера. Если важен холодный старт, воспроизводите его на отдельном стенде. Сравнивайте и прогретый режим: именно он часто определяет повседневную работу приложения.
Для быстрой проверки альтернативного плана можно локально изменить настройки планировщика, например SET LOCAL enable_nestloop = off. Это диагностический эксперимент, не исправление SQL и не гарантия полного исключения алгоритма. Если альтернативный план быстрее, найдите, почему штатная оценка выбрала иначе. Настройки планировщика.
Убедительный отчёт связывает причину и результат: «внутренний поиск выполнялся 40 000 раз; после сокращения внешнего набора loops снизился до 300, временные записи исчезли, а задержка приложения уменьшилась на сопоставимой нагрузке». Эти числа — пример формата отчёта, не замер из данной статьи.
Шпаргалка по сигналам
| Наблюдение | Что проверить следующим | Частая ошибочная реакция |
|---|---|---|
| Actual rows намного больше оценки | Статистику, связи столбцов, параметры | Запретить Nested Loop глобально |
| Малое время узла и огромный loops | Внешний вход, коррелированный подзапрос | Игнорировать узел как быстрый |
| Много shared read | Прогрев, I/O timing, объём чтения | Считать все блоки физическим I/O |
| External merge, temp written | Объём сортировки и бюджет памяти | Поднять work_mem всем сессиям |
| Heap Fetches у Index Only Scan | Видимость страниц и интенсивность изменений | Добавить ещё INCLUDE-столбцов |
| План быстрый, API медленный | Пул, блокировки, сеть, сериализацию клиента | Создать индекс без гипотезы |
Навык чтения планов нужен и разработчику, и инженеру баз данных. Для практики возьмите один запрос своего учебного проекта и подготовьте два артефакта: исходный JSON-план и объяснение одного измеренного улучшения. Требования работодателей можно сверить в вакансиях DBA и backend-разработчиков.