DBA на собеседовании: диагностика медленного PostgreSQL
Интервьюер говорит: «PostgreSQL внезапно стал медленным, что будете делать?» Ответ с немедленным VACUUM FULL, перезапуском или добавлением индекса опасен. DBA сначала ограничивает ущерб, сохраняет диагностические следы и разделяет классы проблемы: один запрос, блокировки, истощение ресурсов, изменение плана, сбой хранилища или нагрузочный всплеск.
Хороший кейс движется по времени инцидента. Что изменилось, когда началось ухудшение, кого затронуло, какие операции ещё работают, есть ли риск потери данных? Затем появляются наблюдения, гипотезы, минимально рискованные проверки, восстановление и меры против повторения. Команды важны, но порядок и причина каждой команды важнее.
Triage без уничтожения улик
Сначала подтвердите симптом на стороне базы: latency транзакций, число активных и ожидающих сессий, saturation CPU и диска, ошибки соединений, lag реплик. Проверьте, весь ли кластер затронут или один endpoint, база, tenant либо тип запроса. Это определяет масштаб и безопасную тактику.
Спросите о недавних изменениях: deploy приложения, миграция, сбор статистики, рост данных, failover, настройка памяти. Временная корреляция не доказывает причину, но задаёт порядок гипотез. Зафиксируйте pg_stat_activity, дерево блокировок, метрики и текст проблемных запросов до перезапуска, потому что рестарт обнулит часть состояния.
Ограничение ущерба выбирают по обратимости. Можно снизить concurrency конкретного job, отменить runaway query, переключить тяжёлый отчёт на реплику или временно отключить endpoint. Убийство всех соединений создаст stampede и откаты длинных транзакций, поэтому требует отдельного основания.
Не запускайте диагностическую команду только потому, что она знакома. Сначала проговорите её стоимость, обратимость и то, какие следы она может уничтожить.
План запроса читают вместе с фактом
Возьмите нормализованный запрос и сравните текущий план с прежним, если он сохранён. EXPLAIN (ANALYZE, BUFFERS) исполняет запрос, поэтому на production его используют только после оценки стоимости и безопаснее на реплике или с ограничениями. Для изменяющих запросов простой EXPLAIN либо воспроизведение на копии предпочтительнее.
Смотрите на расхождение estimated и actual rows, циклы, время узлов, чтение shared buffers, spill во временные файлы и порядок join. Последовательное сканирование само по себе не ошибка: для большой доли таблицы оно может быть дешевле индекса. Диагноз должен объяснить, почему выбранный доступ дорог именно на фактическом объёме.
Причиной плохой оценки бывают устаревшая статистика, коррелированные столбцы, параметризированный generic plan или резкий skew. Решение может включать ANALYZE, extended statistics, переписывание запроса, подходящий индекс или изменение параметризации. Каждое вмешательство проверяют на write amplification и планах соседних запросов.
| Наблюдение | Гипотеза | Проверка | Безопасное действие |
|---|---|---|---|
| много wait events Lock | очередь блокировок | дерево blocker/waiter | отменить источник после оценки |
| actual rows выше estimate | ошибка статистики | план и распределение | ANALYZE или statistics |
| temp bytes растут | spill sort/hash | узлы и work_mem | сократить набор или точечно память |
| connections у потолка | pool/stampede | состояния и источник | ограничить producer |
Locks: найти блокирующего, не наказать ожидающего
Длинный список активных сессий может быть очередью за одним lock. Постройте цепочку blocker → waiters, определите тип блокировки, возраст транзакции и бизнес-операцию владельца. Самый долгий запрос в очереди не обязательно виноват: он мог ждать транзакцию, которая простаивает idle in transaction.
Перед отменой blocker оцените цену rollback и целостность внешнего процесса. pg_cancel_backend отменяет текущий запрос мягче, pg_terminate_backend завершает сессию и откатывает транзакцию. DDL, ожидающий ACCESS EXCLUSIVE, способен накопить очередь обычных запросов; иногда безопаснее отменить миграцию, чем завершать десятки клиентов.
Детектор deadlock в PostgreSQL прерывает одну из конфликтующих транзакций, чтобы остальные могли продолжить. Параметр deadlock_timeout лишь откладывает запуск проверки и не разрешает цикл сам по себе. DBA исправляет порядок захвата ресурсов и длину транзакций, а приложение повторяет отменённую операцию ограниченно и только при идемпотентности.
Восстановить сервис и доказать устойчивость
После mitigations проверьте пользовательский маршрут, p95/p99 latency, число waiting-сессий, error rate, saturation и replication lag. Падение CPU не означает восстановление, если очередь соединений ещё разбирается или приложение продолжает повторять ошибки. Согласуйте окно наблюдения до закрытия инцидента.
Постоянное исправление отделите от аварийного. Временная отмена отчёта может вернуть сервис, но далее нужны индекс с безопасным способом построения, декомпозиция миграции, ограничение batch, настройка пула или изменение запроса. Для индекса оцените размер, время, блокировки, WAL и место на диске.
Postmortem связывает сигнал, решение и guardrail. Если план регрессировал после роста таблицы, добавьте плановый анализ статистики и наблюдение за top queries. Если lock вызвала миграция, внедрите lock timeout, предварительную проверку и канареечный запуск.
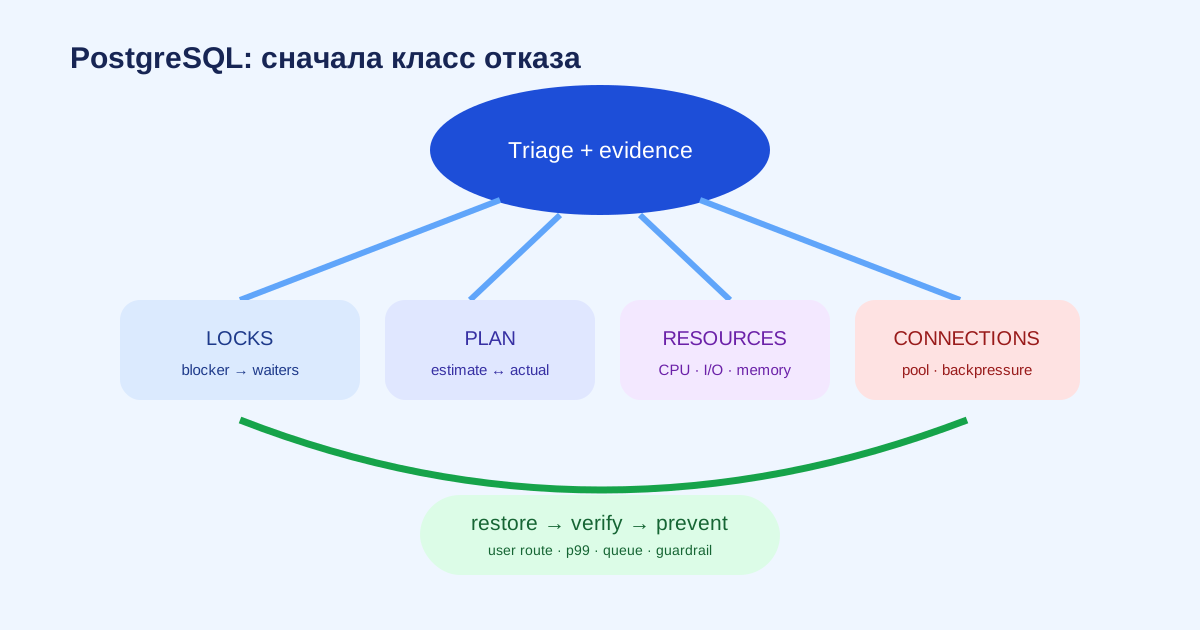
Схема показывает опорные решения кейса «DBA на собеседовании: диагностика медленного PostgreSQL».
Как отвечать у доски
Начните с пяти вопросов о масштабе и риске, затем нарисуйте ветвление: resource saturation, slow query, locks, connections, storage. Выберите одну ветку по данным интервьюера и углубитесь. Не перечисляйте весь каталог PostgreSQL; объясняйте следующий шаг через то, что уже увидели, и называйте условие смены гипотезы.
Требования к вакансиям DBA помогут выбрать релевантные примеры эксплуатации, а зарплатный обзор — оценить уровень позиции. В самом рассказе покажите не размер базы, а качество решений: безопасность, наблюдаемость, восстановление и профилактику.
Автовакуум оценивайте по мёртвым tuple, возрасту xid, длительности прохода и конкуренции за I/O. Простое повышение частоты иногда усиливает нагрузку. Для горячей таблицы полезнее настроить пороги адресно и проверить, почему транзакции удерживают старые версии.
Реплика не всегда безопасна для тяжёлого анализа. Длинный snapshot конфликтует с replay, а высокий lag делает данные непригодными для оперативного решения. Назовите допустимую свежесть и приоритет восстановления репликации до переноса отчёта.
При suspected storage issue сопоставьте database wait events с latency устройства и системными ошибками. Один высокий IOPS без очереди может быть нормой. Проверка файловой системы и диска идёт через инфраструктурную команду, а DBA сохраняет временную линию и влияние на WAL.
Connection pool защищает базу лишь при согласованных лимитах. Если каждый pod держит собственный максимум, горизонтальное масштабирование приложения внезапно превышает max_connections. В профилактике покажите общий бюджет, резерв для администрирования и backpressure на входе.
План отката индекса отличается от отката конфигурации. CREATE INDEX CONCURRENTLY снижает блокировки, но работает дольше и может оставить invalid index после сбоя. Кандидат должен упомянуть мониторинг фаз, диск, проверку валидности и уборку артефакта.
Репетируя инцидент, отделите факт от команды. Вместо «я сделал REINDEX и помогло» объясните наблюдение corruption или bloat, альтернативы, риск блокировки и критерий успеха. Без этой связки даже удачный результат выглядит случайным администрированием.
Мини-кейс: deploy, новый план и очередь locks
После deploy p99 вырос только у оформления заказа. DBA сохранил pg_stat_activity, wait events и планы до рестарта. Корневой blocker оказался коротким UPDATE, который ждал DDL с ACCESS EXCLUSIVE; за ним уже стояла очередь пользовательских транзакций. Миграцию отменили как наиболее обратимое действие, а не завершали всех клиентов.
После разгрузки обнаружился второй фактор. Новый параметр запроса дал generic plan с сильной недооценкой строк на одном tenant, hash join начал писать temp files. Статистику и распределение проверили на production-like копии, затем добавили extended statistics и переписали условие. Глобальный work_mem не трогали: память расходовалась бы на множество узлов параллельных запросов.
Восстановление подтвердили по пользовательскому checkout, latency, errors, числу waiting sessions и отставанию реплики. Падение CPU было лишь одним сигналом. Миграцию пересобрали с коротким lock timeout, предварительной проверкой и отдельным окном.
Перед постоянным изменением DBA проверил соседние запросы: новая статистика улучшала проблемный tenant, но могла сменить join order у общего отчёта. Планы сравнили на нескольких распределениях данных, а post-deploy наблюдение включило top queries и temp bytes. Это превратило точечное ускорение в контролируемое изменение оптимизатора, а не в удачный единичный план.
Если в том же разборе встретился deadlock, формулировка должна быть точной: PostgreSQL обнаруживает цикл после задержки deadlock_timeout и прерывает одну транзакцию. Увеличение задержки не исправляет порядок locks. Такой ответ отделяет механизм базы, временную mitigation и постоянный fix.