Внедрение AI: как считать эффект автоматизации
Эффект AI-автоматизации часто считают от демонстрации: модель за двадцать секунд сделала то, на что сотрудник тратил десять минут. Этот расчёт почти всегда завышен. В рабочем потоке остаются поиск входных данных, проверка результата, исправление ошибок, эскалация редких случаев, интеграция и наблюдение. Специалист по AI workflow доказывает ценность на полном процессе и заранее определяет качество, при котором автоматизация безопасно меняет действие человека.
Зафиксируйте baseline на реальной очереди
Начните не с модели, а с единицы работы: обращение, документ, карточка товара, сверка договора. Разделите цикл на ожидание и активный труд. Если аналитик редактирует заявку пять минут, но она лежит в очереди два дня, ускорение генерации текста не обязательно изменит клиентский SLA. Замерьте медиану и хвост распределения, частоту переделок, стоимость исполнителя и долю исключений.
Выборка должна отражать рабочую смесь. Лёгкие записи дают эффектную демоверсию, однако реальная цена живёт в длинных документах, плохо заполненных полях и спорных категориях. Зафиксируйте сегменты до пилота: язык, канал, сложность, риск, наличие эталона. Сохраните контрольный набор, который не использовался при настройке prompts и порогов.
Baseline включает качество человека. Ошибка модели не сравнивается с воображаемой безошибочной операцией. Соберите inter-rater agreement, долю пересмотров и downstream-последствия человеческих решений. Иногда AI повышает единообразие, хотя среднее время почти не меняется; иногда ускоряет первый проход, но переносит труд в контроль.
Секунды ответа модели — техническая latency. Экономический baseline измеряет путь одной рабочей единицы до принятого результата.
В кейсе для AI workflow specialist назовите источник замера, период и размер сегментов без раскрытия чувствительных данных. Сильнее всего выглядит baseline, после которого команда отказалась автоматизировать неподходящую часть процесса.
Соберите eval вокруг цены ошибки
Средняя accuracy скрывает разные последствия. Ошибка в черновике описания легко исправима, неверная блокировка платежа требует другого порога и обязательной проверки. Постройте taxonomy ошибок: пропуск, лишнее действие, неверное поле, неподтверждённый факт, нарушение формата, небезопасный контент. Каждому классу назначьте тяжесть и маршрут.
| Класс исхода | Что измерять | Допустимое действие | Контроль |
|---|---|---|---|
| Низкий риск | полезность и время правки | показать черновик | выборочная проверка |
| Средний риск | precision, полнота полей | предложить решение человеку | обязательное подтверждение |
| Высокий риск | критические ошибки отдельно | не выполнять автоматически | правило и двойная проверка |
| Неизвестный случай | coverage и drift | отправить в fallback | журнал причин эскалации |
Eval должен повторять производственный интерфейс. Если пользователь видит исходный документ и подсветку, его качество проверки отличается от оценки голого ответа. Измеряйте end-to-end: принят ли результат, сколько времени ушло на исправление, заметил ли оператор опасную ошибку. Offline-набор нужен для быстрых сравнений, но не заменяет пилот.
Порог выбирают по utility, а не по круглому score. Постройте кривую coverage–quality: сколько работы система может взять при заданной цене ошибки. Для auto-action нужен узкий сегмент с высокой уверенностью; для draft mode допустима большая coverage. Зафиксируйте версии модели, prompt, retrieval и правил, чтобы повторить результат.
Спроектируйте рабочее место человека в контуре принятия решения
Человек не должен заново выполнять всю задачу после AI. Покажите источник, спорные фрагменты, уверенность по нужным полям и быстрые действия: принять, исправить, отклонить, эскалировать. Порядок очереди учитывает риск и срок. Если оператор вынужден сравнивать два длинных текста глазами, «проверка» съест обещанную экономию.
Калибруйте доверие. На старте можно показывать больше контекста и собирать причины изменений. Затем автоматика берёт только подтверждённые классы. Не обучайте пользователя слепо нажимать «принять»: выборочные контрольные случаи и разбор расхождений помогают заметить automation bias. Скорость без качества отслеживают отдельно.
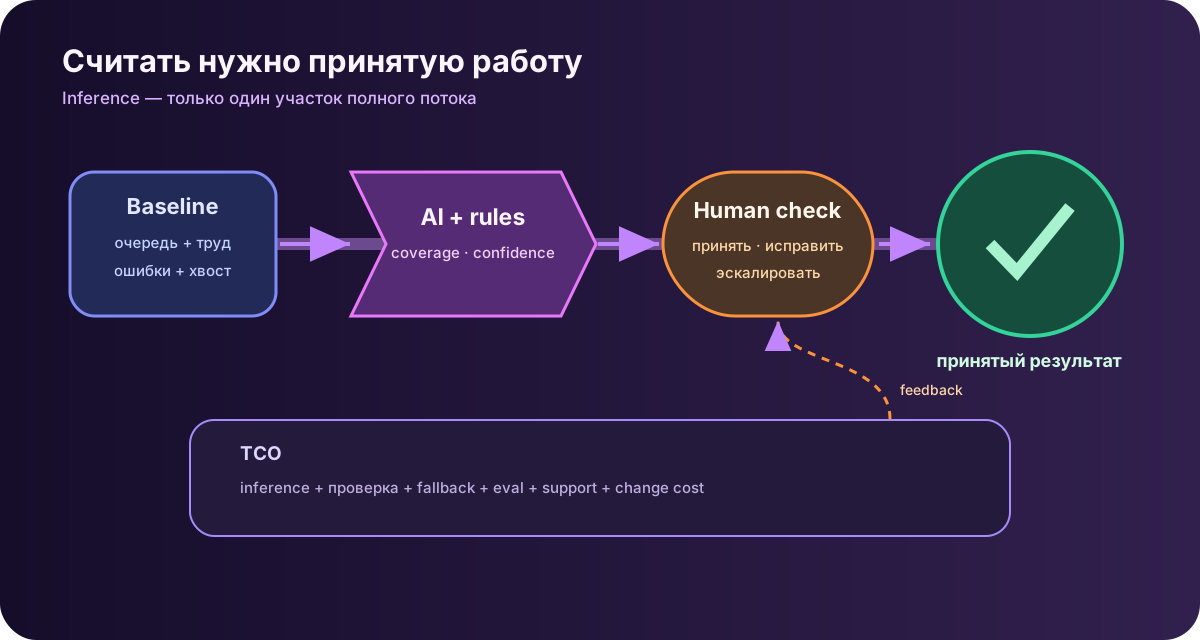 Полный контур включает проверку человеком, fallback и обратную связь в eval.
Fallback — часть продукта, а не признание поражения. Определите причины: низкая уверенность, отсутствующий документ, новый формат, policy block, сбой провайдера. Для каждой есть понятный статус и владелец. Молчаливый пропуск опаснее ручной очереди, потому что пользователь считает работу выполненной.
Обратную связь разделяйте на исправление текущего результата и данные для улучшения. Не каждое редактирование даёт правильную метку: человек может менять стиль или сам ошибаться. Для обучения нужны правила выборки, согласие, очистка чувствительных данных и разбор конфликтов.
Посчитайте TCO без удобных пропусков
Стоимость inference — заметная, но часто не главная строка. Добавьте разработку интеграции, eval-набор, разметку, наблюдение, поддержку, безопасность, обучение пользователей, ручную проверку и fallback. Учитывайте повторные вызовы, длинный контекст, пики нагрузки и минимальные обязательства провайдера. Для локальной модели включите железо, эксплуатацию и резерв мощности.
Переведите эффект в стоимость принятой единицы, а не сырого запроса. Формула может включать AI cost, минуты проверки, долю повторной обработки и стоимость исключений. Сравните с baseline на одинаковой смеси. Если система обрабатывает только простые случаи, остаточная ручная очередь станет сложнее и дороже; средняя стоимость человека вырастет.
Отдельно оцените change cost. Обновление модели может изменить тонкие поля, поэтому нужны regression eval и контролируемый rollout. Провайдерский outage требует очереди или переключения режима. Security review, хранение prompts и удаление данных — реальные работы, даже если не попадают в демо.
ROI без стоимости проверки и исключений — рекламная оценка. Для инвестиционного решения показывайте cash flow и диапазон неопределённости.
Сравнивая ответственность и зарплаты AI workflow specialist, покажите масштаб потока: объём, риск, число интеграций и право менять процесс. Это объясняет ценность роли лучше списка моделей.
Проверяйте эффект после изменения процесса
Пилот начинайте в shadow или draft mode. Система выдаёт результат, но не совершает необратимое действие; команда сравнивает качество и учится маршрутизировать исключения. Затем включите ограниченный сегмент, guardrails и критерий rollback. Решение о расширении принимается по заранее заданному окну, а не после одного удачного дня.
Экономический эффект измеряйте на уровне пропускной способности, SLA, качества и downstream outcome. Высвобождённые часы не равны экономии, если команда не сократила overtime, не обработала больше полезной работы и не перераспределила мощность. Назовите, куда ушёл ресурс, и подтвердите результат этого изменения.
Следите за drift входов, quality by segment, acceptance rate, временем правки, fallback и критическими ошибками. Один общий график скроет деградацию редкого языка или нового шаблона. Порог пересмотра должен запускать конкретное действие: возврат в draft, сужение coverage, обновление eval или остановку.
В портфолио завершите кейс не процентом «автоматизировано», а решением. Например, auto-action оставили для двух стабильных классов, сложные документы перевели в assisted review, а третий сценарий закрыли из-за TCO. Такой итог показывает, что вы оптимизируете рабочую систему, а не добиваетесь максимального использования AI.
Разберите provider outage как часть экономики. В час пик запросы начали завершаться timeout, retries удвоили очередь, а операторский экран показывал «обработка» без срока. Команда сначала отключила повтор на пользовательском request path, перевела новые записи в durable fallback и вернула людям явный статус. После инцидента появились retry budget, circuit breaker и метрика возраста ручной очереди. В TCO добавили стоимость дежурства и резервного режима, а не только потерянные API-вызовы.
Ещё один ценный артефакт — таблица disagree cases. В ней для каждого сегмента указаны ответ модели, решение оператора, решение второго эксперта и downstream outcome. Такой набор отделяет ошибку AI от неоднозначной инструкции. Если эксперты расходятся в policy-классе, повышение модели не решит проблему: владелец процесса должен уточнить правило. Если они согласны, а модель систематически пропускает поле, случай попадает в regression eval. Покажите, как конкретные строки изменили coverage или interface, не раскрывая исходные персональные данные.
Наконец, смоделируйте cash flow при drift. Допустим, acceptance падает на пять пунктов, проверка удлиняется на минуту, а inference дорожает из-за контекста. Укажите порог, после которого workflow возвращается в draft-only, и владельца решения. Такой заранее записанный trigger защищает проект от sunk cost: команда не продолжает auto-action только потому, что уже инвестировала в интеграцию.
Для rollback rehearsal прогоните production-like batch: auto-action отключён, незавершённые записи уходят в ручную очередь, подтверждённые результаты не дублируются, dashboard показывает новый режим. Это проверяет операционную обратимость, а не только положение feature flag.
Runbook закрепляет этот режим: кто видит trigger, кто отключает auto-action и как ручная очередь возвращается к нормальной работе.