AI-разработчик: как доказать инженерность прототипа
Зафиксируйте контракт до разговора о модели
AI-прототип впечатляет на демонстрации, когда автор выбирает удобный запрос и вручную проходит сбой. Инженерный кейс начинается с контракта: кто вызывает систему, какие данные подаёт, какой результат получает, сколько ждёт и что происходит при неопределённости. Опишите допустимые и недопустимые ответы. Для извлечения это схема полей и политика отсутствующих значений; для агента — разрешённые действия и точки подтверждения; для генерации — формат, фактические ограничения и способ отказа.
Разделите недетерминированное ядро и детерминированную оболочку. Модель может предложить классификацию, план или текст, но код обязан валидировать схему, лимиты, права, идентификаторы и переходы состояния. Не поручайте LLM проверку того, что выражается типом, allowlist или SQL constraint. В кейсе полезно показать одну границу: model output попадает в typed parser, затем policy layer разрешает действие, а executor принимает только проверенный payload.
Назовите baseline. До LLM задача могла решаться правилом, поиском, шаблоном, небольшой моделью или человеком. Сравните не только качество, но и цену, latency, поддерживаемость и характер ошибок. Если прототип выигрывает на эффектной длинной инструкции, но проигрывает простому regex на основном потоке, production-решение должно это признать. Иногда лучший дизайн — rule-first с моделью на хвосте, а не универсальный агент.
Ограничьте обещание. «Ассистент понимает документы» слишком широко; «извлекает шесть полей из русскоязычных счетов, отмечает неизвестные и не отправляет платёж» проверяемо. Опишите ручную ветку. Куда попадает низкая уверенность, сколько контекста видит оператор, может ли исправление вернуться в dataset, как исключается повторное действие? Human-in-the-loop — не фраза для слайда, а очередь с SLA, правами и аудитом. Если ручная проверка съедает большую часть экономии, это должно попасть в unit economics и критерий готовности. Зафиксируйте режим деградации при недоступном провайдере. Для справочной генерации допустимо отложить задачу, для проверки платежа может потребоваться полный запрет продолжения, для подсказки — детерминированный baseline. Назовите, какой статус хранится durably, как пользователь повторяет действие и что исключает двойной side effect после позднего ответа. На странице вакансий AI-разработчиков можно увидеть, где работодатели ждут prototyping, а где — полноценный backend, MLOps и безопасность.
Постройте eval вокруг реальных рисков
Демо-набор из пяти удачных примеров не измеряет систему. Соберите стратифицированный корпус: обычные запросы, редкие форматы, длинный контекст, неоднозначность, мусор, adversarial input и случаи, где правильный ответ — отказ. У каждого примера должны быть происхождение, ожидаемое поведение и версия. Уберите персональные данные либо получите законное основание для их хранения. Train, tuning и final evaluation не должны случайно делить почти одинаковые документы.
| Слой оценки | Что измерять | Пример ошибки | Решение по результату |
|---|---|---|---|
| Формат | schema pass rate | пропущено обязательное поле | parser или prompt fix |
| Смысл | task-specific score | неверно выбран класс | data или model change |
| Безопасность | attack success rate | выполнена инструкция из файла | усилить boundary |
| Система | p95 latency и errors | timeout провайдера | retry, fallback, budget |
| Экономика | cost per successful task | дорогой контекст | routing или compression |
Метрика зависит от цены ошибки. Для извлечения суммы важна точность по полям и доля abstain, для retrieval — recall релевантных документов и groundedness ответа, для классификации — confusion matrix по критичным классам. Средний «accuracy 92%» может скрывать полный провал редкой, дорогой категории. Укажите slices и отдельно покажите worst cases.
Eval harness должен воспроизводиться. Зафиксируйте model id, параметры, prompt version, набор и код scorer. Если оценка использует другую LLM, откалибруйте judge на размеченной человеком подвыборке и отслеживайте смещение. Не подменяйте экспертную проверку красивым числом judge score. Сохраните примеры несогласия и правило, кто принимает финальное решение.
Один успешный ответ доказывает возможность. Инженерное качество доказывают распределение результатов, известные пределы и повторяемый запуск eval.
Спроектируйте отказоустойчивый runtime
Укажите путь запроса целиком: ingress, auth, подготовка контекста, provider call, validation, side effect, persistence и response. Для каждой границы назовите timeout, retry и идемпотентность. Повторять можно сетевой вызов чтения, но повтор action после неясного ответа способен создать две заявки или два списания. Нужны idempotency key, durable intent и проверка результата, а не безусловный retry всего workflow.
Провайдер вернёт rate limit, malformed JSON, content refusal, пустой streaming chunk или ответ после client timeout. Решите, какие ошибки retryable, где допустим fallback на другую модель, а где нужно fail closed. Fallback должен сохранять контракт качества и политики; дешёвая модель, которая не умеет tool calling, не является безопасной заменой агента. Пользователь получает понятный статус без raw prompt, stack trace и внутреннего текста провайдера.
Контекст имеет бюджет. Посчитайте токены системной инструкции, истории, retrieved chunks, tool descriptions и ответа. Установите caps на каждый источник, дедупликацию и порядок обрезки. Потеря последних пользовательских ограничений при truncation опаснее, чем удаление ранней болтовни. Для RAG покажите chunking, фильтры доступа, цитирование provenance и реакцию на пустой retrieval.
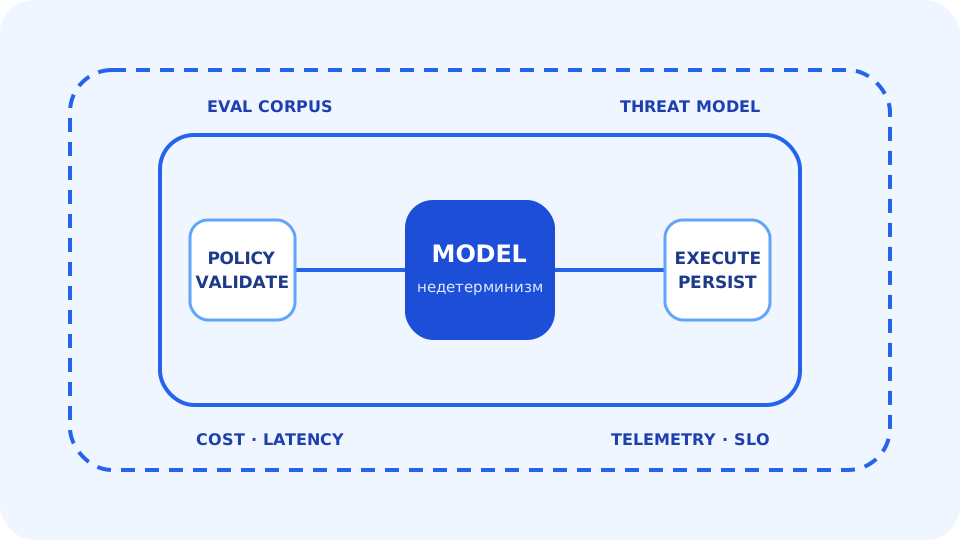 Контур отделяет недетерминированный inference от проверок, side effects, telemetry и бюджетов.
Закройте безопасность до подключения инструментов
Prompt injection — это граница доверия, а не неудачная формулировка prompt. Текст из документа, сайта или письма остаётся данными и не должен менять system policy. Разделите инструкции и content структурно, ограничьте инструменты, валидируйте параметры и авторизуйте каждое действие на сервере. Модель не выдаёт права. Даже если она правильно определила намерение пользователя, executor повторно проверяет ownership и scope.
Минимизируйте данные. Не отправляйте провайдеру лишние поля, secrets, внутренние идентификаторы и полный документ, если нужен фрагмент. Зафиксируйте retention, регион обработки, условия обучения провайдера и способ удаления. Логи не должны хранить prompt и completion по умолчанию: для диагностики часто достаточно версии, длительности, token usage, safe error code и hash запроса. Отдельный защищённый sample может существовать по явной политике.
Tool calling требует allowlist операций и аргументов. Для read-инструмента защититесь от SSRF и чрезмерной выборки; для SQL используйте подготовленные запросы и ограниченную роль; для отправки сообщения покажите preview и human confirmation, если цена ошибки высока. Не разрешайте модели собирать shell-команду из внешнего текста. Ограничьте число шагов, общую стоимость, время и повтор одного tool.
Red teaming строится вокруг активов: данные другого клиента, денежное действие, системная инструкция, доступ к сети, репутационный ответ. Для каждого придумайте abuse cases и автоматизируйте хотя бы стабильные проверки. После любого расширения tools или источников прогоняйте regression-набор: новый capability меняет attack surface даже при прежней модели.
Покажите стоимость и эксплуатацию после релиза
Стоимость считайте на успешную задачу, а не на один provider call. Включите retries, retrieval, embeddings, judge, moderation, cache misses и ручную обработку отказов. Постройте распределение по типам запросов: длинный хвост контекста часто съедает бюджет. Затем покажите рычаги — routing по сложности, кэш детерминированных частей, уменьшение контекста, batching, более дешёвая модель на безопасном классе. Каждый рычаг повторно проходит eval, иначе экономия может незаметно купить регрессию.
Latency разложите на очередь, retrieval, time to first token, generation, tools и post-processing. Пользовательское ощущение можно улучшить прогрессом или streaming, но side effect нельзя считать завершённым до durable подтверждения. Установите SLO по сценарию, а не среднее по сервису. Длинная аналитика и короткая классификация имеют разные ожидания и бюджеты.
Наблюдаемость должна отвечать, что сломалось без чтения чувствительных данных. Полезны request id, model/prompt version, route, tokens, latency stages, validation outcome, retry reason и final status. Dashboard связывает качество с runtime: доля schema failures, abstain, tool denials, cost и user correction. Алерт по HTTP 500 не поймает систему, которая уверенно возвращает неверный класс с кодом 200. Нужны online proxy-сигналы и регулярный offline eval на свежих примерах.
В портфолио покажите путь версии: baseline, первый прототип, обнаруженный failure class, изменение boundary, eval delta, нагрузочный результат и стоимость. Укажите, что осталось нерешённым и при каком трафике архитектуру придётся менять. Диапазон зарплат по выбранному коду доступен на странице зарплат AI-разработчиков. Инженерность видна там, где система умеет ограничивать модель, измерять неопределённость и переживать скучные отказы без ручного спасения.